The Internet: “[ ] I’m not a robot”... Ask Juliana: “Damned !”
Damien Cappelle, ingénieur logiciel chez Indao, raconte comment il a conçu Ask Juliana, l'assistant IA intégré à la plateforme : multi-fournisseurs, sobre en ressources et sous contrôle humain.
Ask Juliana : comment nous avons conçu un assistant IA sobre et sous contrôle humain
Par Damien Cappelle, ingénieur logiciel chez Indao
L'histoire d'Ask Juliana, l'assistant IA intégré à la plateforme Indao, commence à peu près en même temps que mon arrivée chez Indao. Pour être exact, elle commence même pendant mon entretien d'embauche, avec une question sur mon point de vue à propos des LLM (Large Language Models, le type de modèle derrière les services comme Claude ou ChatGPT). Ma réponse honnête (un mélange de fascination, de craintes et de grandes questions éthiques) n'a apparemment pas déplu, puisque je me retrouve maintenant aux commandes de l'intégration des LLM dans nos produits.
Mais que fait Ask Juliana ?
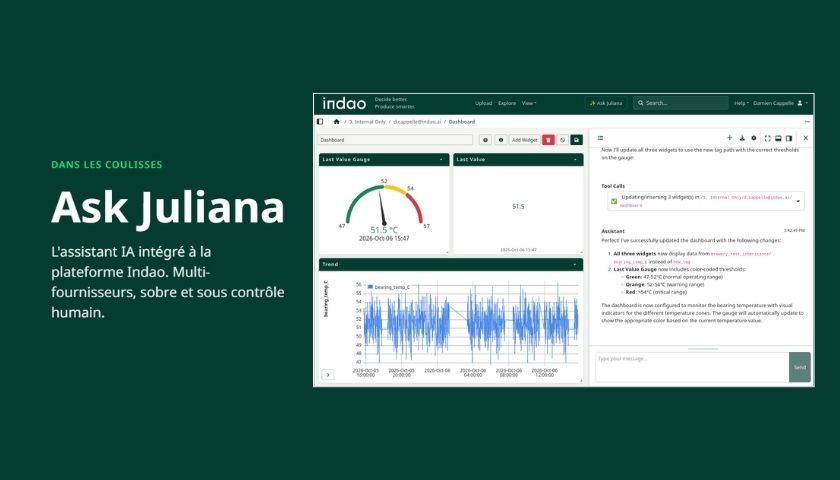
Ask Juliana est un outil d'assistance basé sur un LLM. Il peut s'agir de n'importe quel LLM : nous tenons à rester indépendants d'un fournisseur et voulons laisser à nos clients la possibilité de choisir, en fonction de leurs réalités. L'outil permet principalement de répondre aux questions des utilisateurs, que ce soit à propos de notre produit ou de leurs données industrielles, et d'automatiser le processus de configuration.
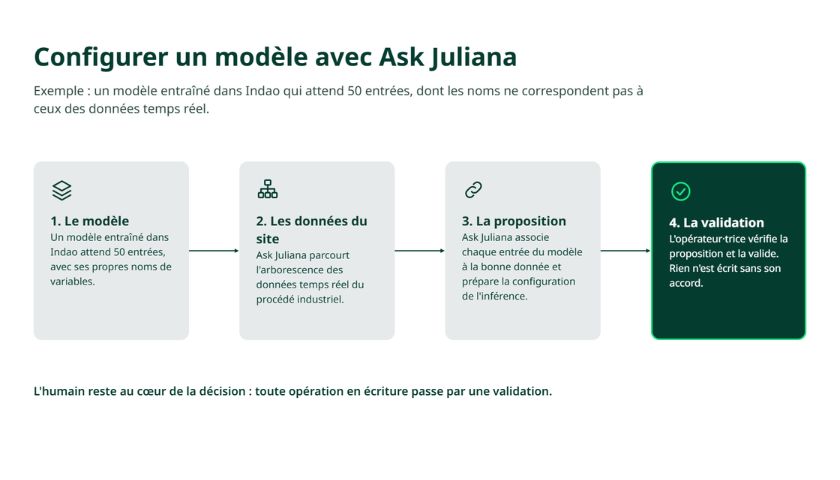
Par exemple, imaginons qu'on ait un super modèle entraîné dans Indao qui nécessite 50 entrées, avec des noms de données temps réel qui ne correspondent pas forcément aux noms spécifiés dans le modèle. Ask Juliana pourra prendre le modèle, parcourir l'arborescence des données issues du processus industriel et configurer l'inférence du modèle. Dans un cas comme celui-ci, c'est, selon notre estimation, jusqu'à une heure de configuration manuelle économisée.
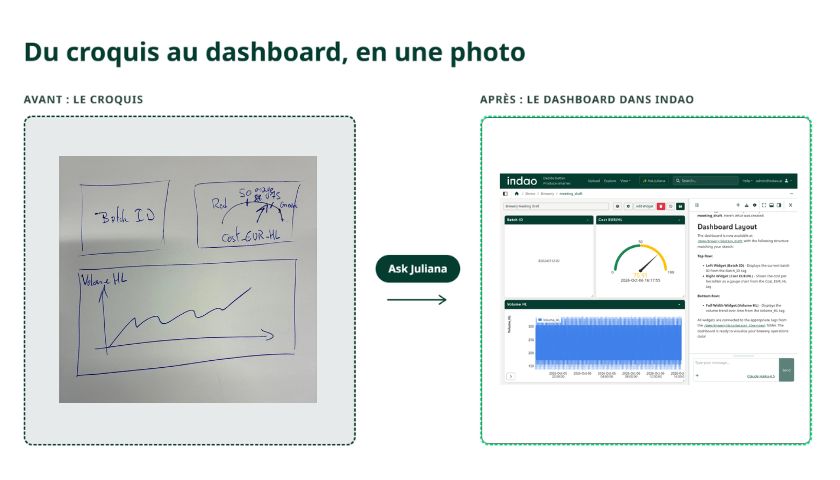
Évidemment, les capacités sont bien plus larges. Par exemple, la création de dashboards sur base de la photo d'un flipchart est en phase de test. D'autres fonctionnalités sont en cours de développement, comme la sélection et l'entraînement des modèles ou le diagnostic.
Questionnement éthique
Je l'ai évoqué en introduction : le développement de l'IA générative, et des LLM spécifiquement, me pose beaucoup de questions éthiques (consommation d'eau et d'électricité, extraction des matières premières, souveraineté, perte de compétences…). Lorsqu'il m'a été demandé de travailler sur cet agent, j'ai voulu trouver des pistes de réponse à ces questions. Voici les pratiques mises en place pour diminuer son impact.
Ne pas se lier à un fournisseur
En faisant le choix de la compatibilité avec plusieurs fournisseurs, nous offrons à nos clients la possibilité de choisir une solution qui correspond à leurs besoins et à leurs contraintes (coût, souveraineté, open source ou propriétaire, etc.). Cela implique un travail de maintenance supplémentaire, mais je crois vraiment à son importance.
Optimisation de l'utilisation des ressources
J'ai beaucoup travaillé sur cette question : ne charger en contexte que les données utiles, optimiser la manière de documenter les outils disponibles pour l'agent, orchestrer des sous-agents, etc. Aujourd'hui, l'énorme majorité des tâches fonctionne sur des modèles légers. La création de dashboards depuis un prompt ou une photo est par exemple tout à fait possible avec Claude Haiku 4.5. Certaines tâches fonctionnent même avec des modèles très légers : plein de choses peuvent déjà être faites avec Ministral 3 14B de Mistral, un modèle open source de 14 milliards de paramètres.
Cela offre une série d'avantages :
- un coût d'utilisation réduit ;
- un impact environnemental plus faible ;
- un plus large choix de fournisseurs et de modèles ;
- une plus grande rapidité d'exécution.
Cela ouvre aussi une perspective : faire tourner des modèles sur des machines locales, une piste que nous n'avons pas encore investiguée.
L'opérateur·trice garde la main
Dans notre architecture, il est garanti par programmation que toute opération en écriture (une configuration, par exemple) se fait uniquement avec l'aval de la personne qui utilise l'outil. Des interfaces de visualisation et de validation des appels aux outils permettent d'avoir un contrôle complet sur le résultat. L'humain reste ainsi au cœur du processus de décision. L'objectif est de vous faire gagner du temps, pas de vous voler votre esprit critique.
Utilisé avec sobriété et pour des usages concrets, comme l'optimisation des procédés industriels, un LLM devient un outil dont l'impact se justifie.
Challenge technique
Avant de clôturer, je voudrais aborder les difficultés liées au travail sur ce type de sujet. En tant qu'ingénieur logiciel, j'ai été habitué à transcrire des demandes de fonctionnalités en exigences techniques, en code et surtout en tests déterministes. Ces tests permettent de prouver que telle ou telle exigence ou fonctionnalité correspond aux attentes. Le travail avec un LLM nécessite de revoir sa manière de réfléchir aux fonctionnalités.
Premièrement, la liste des fonctionnalités n'est pas finie. Pas plus tard qu'il y a une semaine, je discute avec un collègue de la possibilité d'identifier des capteurs défaillants avec Juliana, et il me dit : « mais ça marche déjà ». Effectivement, grâce à un outil de statistiques que j'avais implémenté moi-même, l'agent sait déjà tirer des conclusions. Je n'y avais juste pas pensé ! La liste des outils mis à disposition de l'agent est finie, mais leur orchestration laisse énormément de possibilités, et c'est d'autant plus vrai que le LLM utilisé est performant.
Deuxièmement, rien n'est déterministe (surtout en été 🌡️🤭). Un utilisateur peut employer un vocabulaire un peu différent dans son prompt (« folder » à la place de « directory »), et bardaf, c'est l'embardée ! Ne parlons même pas du passage d'un modèle à l'autre. On ne peut plus valider les fonctionnalités comme avant, et il est d'autant plus difficile d'assurer la non-régression lorsqu'on fait des modifications.
Pour faire face à ces difficultés, nous avons mis en place un outil de benchmarking. Il joue une série de prompts liés à un contexte et valide l'utilisation des outils ainsi que la consommation, évaluée en nombre de tokens et en prix, pour un modèle donné. Notre équipe effectue également une validation humaine.
Conclusion
Malgré ces difficultés techniques, nous avons aujourd'hui un agent LLM fonctionnel, qui peut réellement aider les utilisateurs et utilisatrices sur le terrain. Les idées n'arrêtent pas de germer, et la pile de fonctionnalités à implémenter grandit de jour en jour.
Et qui sait, peut-être que mon travail facilitera le vôtre demain ?
Envie de voir Ask Juliana à l'œuvre sur vos données ? Demandez une démo.